المصادر مراجعة بتاريخ 11 أكتوبر 2026.
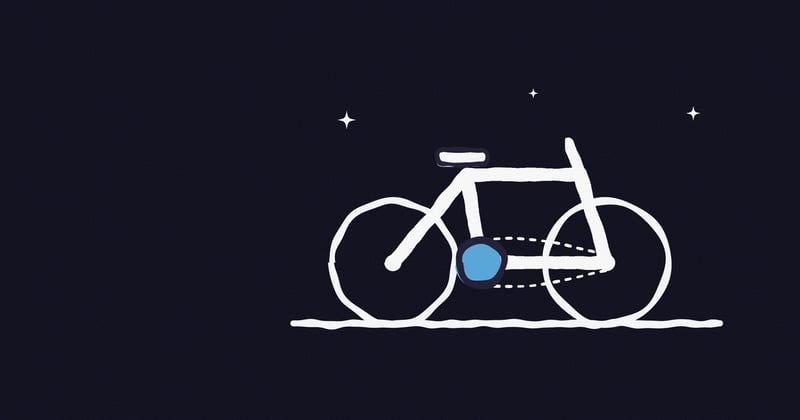
جيب قلم وارسم عجلة (bicycle). م لازم تكون رسمه سمحه. اللستكين مرسومين ف الورقه أصلاً، إنت بس زيد الهيكل والبدّالات والجنزير.
ف 2006، Rebecca Lawson ادّت الورقه دي لـ 81 زول ف يوم مفتوح لجامعه ف إنجلترا. أغلبهم نادراً بيركبو عجله أو م بيركبوها خالص، مع إنو 97% من الما بيركبو ف دراساتها كانو اتعلمو الركوب زمان. وأكتر من 40% من غير الخبراء عملو غلطه واحده على الأقل، ف الرسم وف نسخة اختيار من متعدد لنفس السؤال. [1]
أشهر غلطه كانت الجنزير ملفوف على اللستكين الاتنين، وده معناهو انو حيتمطّ كل مره السواق يلف. وفي ناس وصلو الهيكل باللستك القدّام، يعني العجله م بتقدر تلف أصلاً.
قبل الاختبار، غير الخبراء قيّمو معرفتهم بطريقة شغل العجله بـ 4.6 من 7. ولمّن قالو لمجموعه تانيه انو الاختبار عن كيف العجله بتشتغل، م فرقت معاهم، بالعكس غلطو أكتر. والخبراء البيركبو عجل، 9% بس منهم غلطو ف الرسم، يعني المعرفه دي ممكن تتعلم. بس م بتجي من الركوب. [1]
الفرق ده، بين إنك تحس إنك عارف وإنك تقدر توريها، ليهو اسم. وبقى مهم أكتر هسه، لأنو شرح واضح لأي حاجه تقريباً بقى على بعد prompt واحد.
الإحساس بينزل لمّن تحاول
Leonid Rozenblit وFrank Keil سمّوهو وهم العمق التفسيري (illusion of explanatory depth). ف دراساتهم ف Yale، الناس قيّمو فهمهم لأجهزه بنستعملها كل يوم، زي السوسته وسيفون الحمام والقفل، على مقياس من 7. بعداك كتبو شرح خطوه بخطوه لكيف كل واحد فيهم بيشتغل، وجاوبو سؤال محتاج الآليه نفسها (كيف ممكن تفتح القفل ده بدون مفتاح؟)، وقرو شرح خبير. وبعد كل خطوه قيّمو نفسهم تاني. [2]
التقييم نزل بعد الكتابه، ونزل تاني بعد السؤال. وبعدها 12 طالب تانيين قيّمو الشروحات المكتوبه. درجاتهم كانت أقل بشكل واضح من أول تقييمين للكتبو الشروحات، وم اختلفت عن التقييمات الجات بعد كده. [2]
يعني بعد المحاوله، الناس ختّو نفسهم تقريباً ف المكان الختّاهم فيهو المقيّمين من برّه. ومافي زول علّمهم أي حاجه بين التقييم الأول والتالت. المجهود البذلوهو عشان يشرحو هو الصحّح الصوره.
ف تفصيلتين من الورقه تستاهل تحفظهم. الوهم كان أصغر بكتير ف الحقائق زي عواصم الدول وف قصص الأفلام، وم ظهر خالص ف الإجراءات (procedures)، لأنك بتعرف طوالي إذا كنت عارفها ولا لا. وأكتر حاجه بتتنبأ بالثقه الزايده ف أي جهاز كانت نسبة أجزاؤو الظاهره لأجزاؤو المخفيه. [2] بنشوف السوسته من برّه كل يوم، وبنفتكر داك معناهو إننا عارفين جوّاها.
والإجابه السلسه من الـ model كلها أجزاء ظاهره.
الإجابه الواضحه بتعمل شنو ف الإحساس ده
القلق ده أقدم من الـ chat assistants. ف 2015، Matthew Fisher وMariel Goddu وKeil نشرو تسعه تجارب، البحث ف الإنترنت فيها رفع تقدير الناس لمعرفتهم هم. وخلاصتهم كانت انو الناس "بيخلطو بين الوصول للمعلومه وفهمهم الشخصي ليها" (ترجمتي). [3]
والـ assistant بيخلي الوصول ده أسهل، والدراسات الجديده بتشاور على نفس الاتجاه.
Mark Steyvers وزملاؤه ورّو 301 زول إجابات من GPT-3.5 وPaLM2 وGPT-4o، وسألوهم احتمال كل إجابه تكون صاح قدر شنو. الناس كانو أضعف بكتير من درجات الثقه الداخليه للـ models نفسها ف إنهم يفرّقو بين الإجابه الصاح والغلط. والشروحات الأطول رفعت ثقتهم بدون م تخليهم أحسن ف التفريق ده. [4]
Daniela Fernandes وزملاؤها طلبو من 246 زول يحلّو 20 مسأله منطق من اختبار الـ LSAT باستخدام ChatGPT. متوسط درجاتهم كان 12.98، وهم قدّرو نفسهم بـ 16.50. والعندهم معرفه أكتر بالـ AI كانو أكتر ثقه وأقل دقه ف تقدير أداءهم. [5] (الأرقام دي من نسخة الـ preprint، والدراسه اتنشرت بعدين ف Computers in Human Behavior.)
ف دراسه من مؤتمر سنة 2026، طلبو من 102 طالب يشرحو كيف حاجات زي السوسته بتشتغل، بعد م قرو نفس النصوص القصيره. مجموعه استلمت النصوص كإجابات من ChatGPT على أسئله سألوها هم، ومجموعه تانيه استلمتها بدون مصدر. مجموعة ChatGPT كانت الأكتر مبالغه ف تقدير قدرتها على الشرح، وكتبت شروحات أقصر وأضعف. [6] الدراسه صغيره والإجابات كانت مكتوبه من قبل، فأنا بقراها كاتجاه، م كحجم أثر.
وف تجربه ميدانيه على قريب الألف طالب رياضيات ف الثانوي، استخدام GPT-4 العادي رفع درجات التمارين بـ 48% ونزّل درجات امتحان جا بعد كده، اتعمل بدون AI، بـ 17%. والطلاب م حسّو انهم اتعلمو أقل. [7] واتكلمنا عن الدراسه دي ف مقال قبل كده. [8]
مافي حاجه من ديل بتقول انو الـ AI بيخلي الناس أغبياء. بتقول حاجه أضيق من كده: الإحساس بالفهم رخيص، والإجابه الواضحه بتنتجو سواء اتعلمت حاجه ولا م اتعلمت.
ارسم العجله قبل م تقفل الـ tab
نفس الطريقه الكشفت الوهم، هي الطريقه البيتبني بيها الفهم.
ف تجربة Henry Roediger وJeffrey Karpicke ف 2006، 180 طالب ذاكرو نص نثري، يا بقروهو أربعه مرات، يا بقروهو مره واحده وبعداك يسترجعوهو من راسهم تلاته مرات. بعد خمسه دقايق، القرو أكتر كانو متذكرين أكتر. بعد أسبوع الترتيب اتقلب: مجموعة الاسترجاع اتذكرت 61% من الأفكار، والقرّايين 40%. والقرّايين ديل برضو كانو الأكتر ثقه انهم حيتذكرو. [9]
والشرح زيو بالضبط. ف دراسة Michelene Chi ف 1994، طلاب الصف التامن الطلبو منهم يشرحو لنفسهم كل سطر ف نص عن الدوره الدمويه، درجاتهم زادت 32% بين الاختبار القبلي والبعدي، مقابل 22% لزملاءهم القرو النص مرتين. [10] الدراسه صغيره، 24 طالب، بس دي نفس العاده الاختبار ده بيطلبها منك.
ف جمله بنسبوها عادةً لـ Einstein، بتقول انو لو م قدرت تشرح حاجه ببساطه فإنت م فاهمها. أنا م لقيت ليها مصدر موثّق. النسخه الموثقه عن Richard Feynman. David Goodstein سألو ليه الجسيمات الـ spin بتاعها نص بتتبع إحصاء Fermi-Dirac. Feynman وعد يحضّر ليها محاضره لطلاب السنه الأولى، ورجع بعد كم يوم وقال: "م قدرت أنزّلها لمستوى السنه الأولى. ده معناهو إننا م فاهمينها فعلاً" (ترجمتي). [11]
عشان كده، دي الطريقه البقترحها قبل م تقفل chat علّمك حاجه. هي نفس طريقة Rozenblit وKeil، بس موجّهه ليك إنت.
لو الرقم التاني طلع أقل من الأول، مافي حاجه غلط حصلت. ده أول قياس صاح عندك، والفرق ده هو الجزء من الإجابه اللسه محتاج تتعلمو.
المره الجايه لمّن إجابه تحسسك انها واضحه، اقفل الـ tab وارسم العجله.
المصادر
[1] Lawson: The science of cycology. مجلة Memory and Cognition، العدد 34(8)، 2006؛ نسخة الكاتبه، مؤرشفه.
[2] Rozenblit وKeil: The misunderstood limits of folk science. مجلة Cognitive Science، العدد 26(5)، 2002.
[3] Fisher وGoddu وKeil: Searching for explanations. مجلة Journal of Experimental Psychology: General، العدد 144(3)، 2015.
[4] Steyvers وزملاؤه: What large language models know and what people think they know. مجلة Nature Machine Intelligence، يناير 2025.
[5] Fernandes وزملاؤها: Performance and metacognition disconnect when reasoning in human-AI interaction. نسخة preprint التانيه؛ اتنشرت باسم "AI makes you smarter but none the wiser" ف Computers in Human Behavior، العدد 175، 2026.
[6] Aslanov وFelmer وGuerra: Overconfidence without understanding?. وقائع مؤتمر Cognitive Science Society، العدد 48، 2026.
[7] Bastani وزملاؤه: Generative AI without guardrails can harm learning. مجلة PNAS، العدد 122(26)، يونيو 2025.
[8] Fkra: The chatbot that lifted practice scores 48% and cut exam scores 17%. مقالنا السابق عن نفس الدراسه.
[9] Roediger وKarpicke: Test-enhanced learning. مجلة Psychological Science، العدد 17(3)، 2006.
[10] Chi وde Leeuw وChiu وLaVancher: Eliciting self-explanations improves understanding. مجلة Cognitive Science، العدد 18(3)، 1994.
[11] Goodstein وGoodstein: Feynman's lost lecture. مجلة Engineering and Science، العدد 59(3)، Caltech، 1996.

رسالة واحدة مع كل مقال جديد، فيها أبحاث وقرارات منتج وما تبلغنا به الفرق.